軟體工程沒有死,它只是換了工作:企業級 Claude 與 Codex 實戰體悟

SOURCE | 資訊源評估
- 準確性: 高 - 基於企業級專案在極限時程下結合 Claude Code 與 Codex 交付的實戰工程復盤,涵蓋目錄約束、Agent Skills 與自動化評測。
- 易理解性: 高 - 結構清晰,以「油門與方向盤」類比 AI 與工程師的關係,將開發流程拆解為六個具體工程步驟。
- 閱讀策略建議: 建議重點精讀「開發前的目錄結構鎖定」、「Skills 跨會話記憶封裝」與「雙軌評測框架(DeepEval/Ragas)」,並與團隊現有 AI 開發規範對照。
NAPKIN | 餐巾紙
- 一句話: AI 接管了 90% 的程式碼實作並成為高速油門,而軟體工程師的核心價值已轉移至決定成敗的 10%:系統設計、資料邊界治理、評測迴圈與最終決策。
- 餐巾紙公式: $$\text{企業級 AI 交付力} = \text{AI 自動化迴圈 (90% 產出)} \times \text{工程師核心護欄 (結構 + Skills + 評測 + 審核)}$$
公式白話解析: 單純放任 AI 寫程式會陷入「修一個錯、出一個錯」的失控死循環;
- 行動觸發: 立即在團隊專案中建立標準化的
skills/目錄與自動化 Eval 腳本,並嚴格執行「禁止 AI 自動 Commit/Push」的分支審查鐵律。
餐巾紙草圖
┌──────────────────────────────────────────────────────────
│ [工程師 10% 護欄] 鎖定目錄結構 + 定義 Harness + 撰寫 Skills
│         ↓ (輸入資料、規則、預期行為與評測框架)
│ [AI 90% 執行迴圈] 寫碼 → 測試 → 評測 → 修復 → 回歸測試
│         ↓ (持續運轉直到無間歇性錯誤與來源衝突)
│ [人工最終決策]    Code Review → 批准 Commit → CI/CD 部署
└──────────────────────────────────────────────────────────
ROUND 1: SKELETON | 骨架掃描
“這篇文章在解決什麼根本問題”
- 核心問題: 當商業端因 Claude Opus 5.5 與 GPT-6.1 Sol 的強大能力而要求「數天內零錯誤交付」時,工程師如何在極限高壓下避免 Vibe Coding 失控,穩定交付企業級系統?
- 核心答案: 將工程重心從「手寫邏輯」轉向「規則制定與閉環驗收」:事前鎖定極簡系統架構與目錄結構,事中透過開放格式 Skills 固化跨會話規範並讓 AI 自主運行「編碼-測試-評測-修復」迴圈,事後嚴格把關資料邊界、。
- 論證結構: 痛點引入(業務端極限期望)→ 核心隱喻(AI 是油門,工程師控方向與閉環)→ 六步工程實踐(結構、Skills、ETL、建構、評測、部署)→ 職場典範轉移總結。
章節骨架
- 油門與閉環控制: 揭示放任 AI 寫碼會導致除錯崩潰,提出由人類設定規則與評測框架、讓 Codex 自主執行「編碼-測試-修復-回歸」六步迴圈的工作模式。
- 開發前與開發中的護欄: 強調先固定 Cookiecutter 式專案目錄結構,再透過討論 Harness(檢索策略、記憶體、延遲限制)與撰寫
skills/解決跨會話失憶問題。 - 資料治理、評測與部署落地: 剖析多語系與複雜表格 PDF 的小樣本 ETL 驗證、雙軌制(技術與商業)自動化評測(95 組標準問答驗證),以及 Docker + Terraform + GitHub Actions 的極簡部署架構。
ROUND 2: DISSECTION | 血肉解剖
“憑什麼這麼說:論證與硬核證據”
論證鏈
┌──────────────────────────────────────────────────────────
│ 業務端認為「有 AI 就能數日交付」帶來極限時程壓力
│   ├─ 若完全放任 AI 自由發揮 → 陷入「修東壞西」除錯地獄
│   ├─ 解法 1 (空間約束):先固定目錄結構與極簡技術棧
│   ├─ 解法 2 (規則持久化):用 agentskills.io 規範消除會話失憶
│   ├─ 解法 3 (自主驗證迴圈):以 95 組 Q&A 結合 LLM-as-a-Judge 自動驗收
│   └─ 結論:AI 完成 90% 實作,工程師憑 10% 架構與評測決定商業成敗
└──────────────────────────────────────────────────────────
關鍵證據與量化數據
- 60 秒延遲硬指標與強制引用規範: 在
answer-with-citationsSkill 中明確規定每個回答必須附帶來源 PDF 引用(無引用則不回答)、完整回應必須實測低於 60 秒,且優先使用檢索而非多餘的 Agent 迴圈。 - 95 組標準樣本自動化評測: 透過單一腳本整合 DeepEval、Ragas 與 LLM-as-a-Judge,一次性自動跑完 95 組預期問答,在 QA 介入前於 UAT 環境攔截問題。
- 90/10 價值重分配法則: AI 承擔 90% 程式碼生產與基礎測試,剩餘 10% 的系統設計、極端資料邊界(跨語系 PDF、關聯表格 OCR、來源衝突一致性)、延遲控制與人工 Code Review 構成工程師的護城河。
隱形假設與邊界條件
- 隱形假設: 團隊擁有充裕的 LLM 算力配額(Token 消耗非瓶頸),且業務問題能明確轉化為可量化的 Golden Dataset(如 95 組標準問答與對應 PDF 來源)。
- 邊界條件: 當系統涉及高度未知的探索性需求、無法事先定義預期輸出,或處於嚴格禁止資料經由第三方模型處理的合規環境時,全自動隔夜迴圈的效益將大幅受限。
ROUND 3: SOUL | 靈魂提取
“如何落地與架構反思”
- 作者盲點: 過度樂觀宣稱「用 JSON 檔案勝過沒時間測試的資料庫」及「部署最簡單」。
- 知識連接: 與 Martin Fowler「持續整合與測試金字塔」一脈相承,並與「Harness Engineering(護欄工程)」及「Context Engineering(上下文工程)」高度呼應——提示詞是暫態的,目錄結構、。
- 行動觸發: 盤點專案中重複對 AI 下達的架構約束與業務規則,抽離為符合開放標準的
skills/Markdown 檔案,並建立至少 50 題涵蓋來源衝突與超時邊界的自動化回歸測試集。
留白提問 (Guided Reflection)
- 提問 1: 當 AI 能在數小時內產出第一版系統,但除錯「自己沒參與決策的程式碼」變得極度痛苦時,團隊該如何重新定義 Code Review 的粒度?
- 架構師視角: 審查重點應從「語法細節與排版」升級為「契約與邊界審查(Contract & Boundary Review)」。
- 提問 2: 當兩份企業內部文件對同一業務邏輯出現矛盾(Source Conflicts)時,為什麼作者強調要「重複運行同一問題多次」來檢測?
- 架構師視角: 這是檢驗 RAG 系統「決定性(Determinism)」的關鍵壓力測試。
跨域映射
- 在 工業自動化與控制理論,這叫 閉環負回饋控制系統(Closed-Loop Feedback Control)——以 Eval 框架作為感測器、誤差修正作為控制器,防止開環生成導致系統發散。
- 在 現代航空工程,這叫 線傳飛控與包絡線保護(Fly-by-Wire & Flight Envelope Protection)——飛行員(工程師)給出航向意圖與安全邊界,飛控電腦(AI Agent)高頻微調翼面,。
DEEP READ | 精讀指引 (Must-Read Segments)
[!IMPORTANT] 學習的本質需要「認知阻力」。
- Claude and Codex are a throttle
- 「This is what AI does. And that’s how you should use it: you set the rules, it runs the loop.」
- 推薦理由: 精準定義了 AI 時代工程師的新職責——從「迴圈內的執行者」抽離為「迴圈外的規則制定者與審批者」,徹底解開 Vibe Coding 陷入除錯死循環的根本原因。
- 5. Evaluation: the most important phase
- 「When two sources conflict, run the same question multiple times and see: does the answer keep pointing to the same sources every time? If it changes, you have a problem.」
- 推薦理由: 點出企業級 RAG 最容易被忽略的生產環境隱患:單次準確率高不代表系統穩定,來源衝突下的輸出震盪與延遲超時才是摧毀使用者信任的致命傷。
STRUCTURE MAP | 全書結構圖
┌──────────────────────────────────────────────────────────
│ 軟體工程換了工作:企業級 AI 交付實戰
│ ├─ 1. 時代困境:模型能力躍升 (Opus 5.5 / GPT-6.1) 引發業務端極限交期壓力
│ ├─ 2. 核心心法:AI 是油門,人類握方向盤(設定規則、驅動六步自主迴圈)
│ ├─ 3. 六階段工程落地法
│ │   ├─ [階段一] 開發前:鎖定 Cookiecutter 標準目錄結構,消滅後期混亂
│ │   ├─ [階段二] 開發中:對齊 Harness 架構約束 + 撰寫持久化 Skills + 嚴禁自動 Commit
│ │   ├─ [階段三] 資料層:聚焦複雜 PDF/多語系/表格關聯 ETL,小樣本批次先行並寫入 Skills
│ │   ├─ [階段四] 建構期:極簡技術棧,集中精力攻克 10% 邊界(延遲、向量檢索、來源衝突)
│ │   ├─ [階段五] 評測期:雙軌指標(技術+商業),以 DeepEval/Ragas 自動跑通 95 組樣本
│ │   └─ [階段六] 部署期:Docker + Terraform + GitHub Actions 自動化基礎設施交付
│ └─ 4. 終局洞察:AI 接手 90% 編碼,工程師憑 10% 設計、資料、評測與判斷力勝出
└──────────────────────────────────────────────────────────
軟體工程沒有死,它只是換了工作:企業級 Claude 與 Codex 實戰體悟 (Architectural Deep Dive)
前言/背景
隨著 Claude Opus 5.5 與 GPT-6.1 Sol 等新一代模型具備無需 README 即可讀懂整個程式碼庫的能力,業務與客戶端普遍產生「下週五就能零錯誤上線」的極端預期。
章節詳細總結
核心機制與技術拆解
為馴服 AI 的高隨機性,作者建立「人定規則、機跑迴圈」的雙層控制機制。

- 空間與架構的強制收斂: 寫下第一行 Prompt 前,先以 Cookiecutter 概念鎖定專案目錄結構,將
data/、prompts/、。 - 透過 Skills 實現跨會話規則持久化: 為解決 Agent 跨會話失憶,採用 Claude Code 與 Codex 共同支援的開放規範(
agentskills.io),於skills/目錄下以 Markdown 定義具備name與description的技能檔(使 Agent 僅在任務匹配時按需載入完整內容,。
架構權衡 (Trade-offs)
- 優勢 (Pros): 預先鎖定目錄結構與 Skills 聲明式護欄,大幅降低 AI 過度設計(Over-engineering)與跨會話遺忘風險;
- 劣勢與成本 (Cons & Overheads): 前期需投入高昂規劃成本準備標準測試資料、目錄骨架與驗證腳本;
- 選型建議: 適用於需求邊界清晰、具明確驗收標準的企業系統與 RAG 應用;
企業級架構與實戰落地
在資料處理(ETL)與應用建構階段,核心挑戰並非模型智商,而是 Context Window 限制、資料隱私與異質資料邊界。
進入驗收階段,評測(Evaluation)取代編碼成為最關鍵的工程瓶頸。

實務上透過整合 DeepEval、Ragas 或 LLM-as-a-Judge 編寫自動化腳本,單次運行自動檢驗 95 組真實樣本查詢,鎖定三大核心指標:
- 引用精確度: 核對回答附帶的來源 PDF 是否真實且精確。
- 來源衝突一致性(Source Conflicts): 重複執行相同查詢,確保回答指向的來源具備高度決定性,不發生隨機漂移。
- 延遲與超時邊界: 嚴格監控端到端延遲與隨機 Timeout(對使用者而言,超時或退回預設錯誤等同於 100% 失敗)。
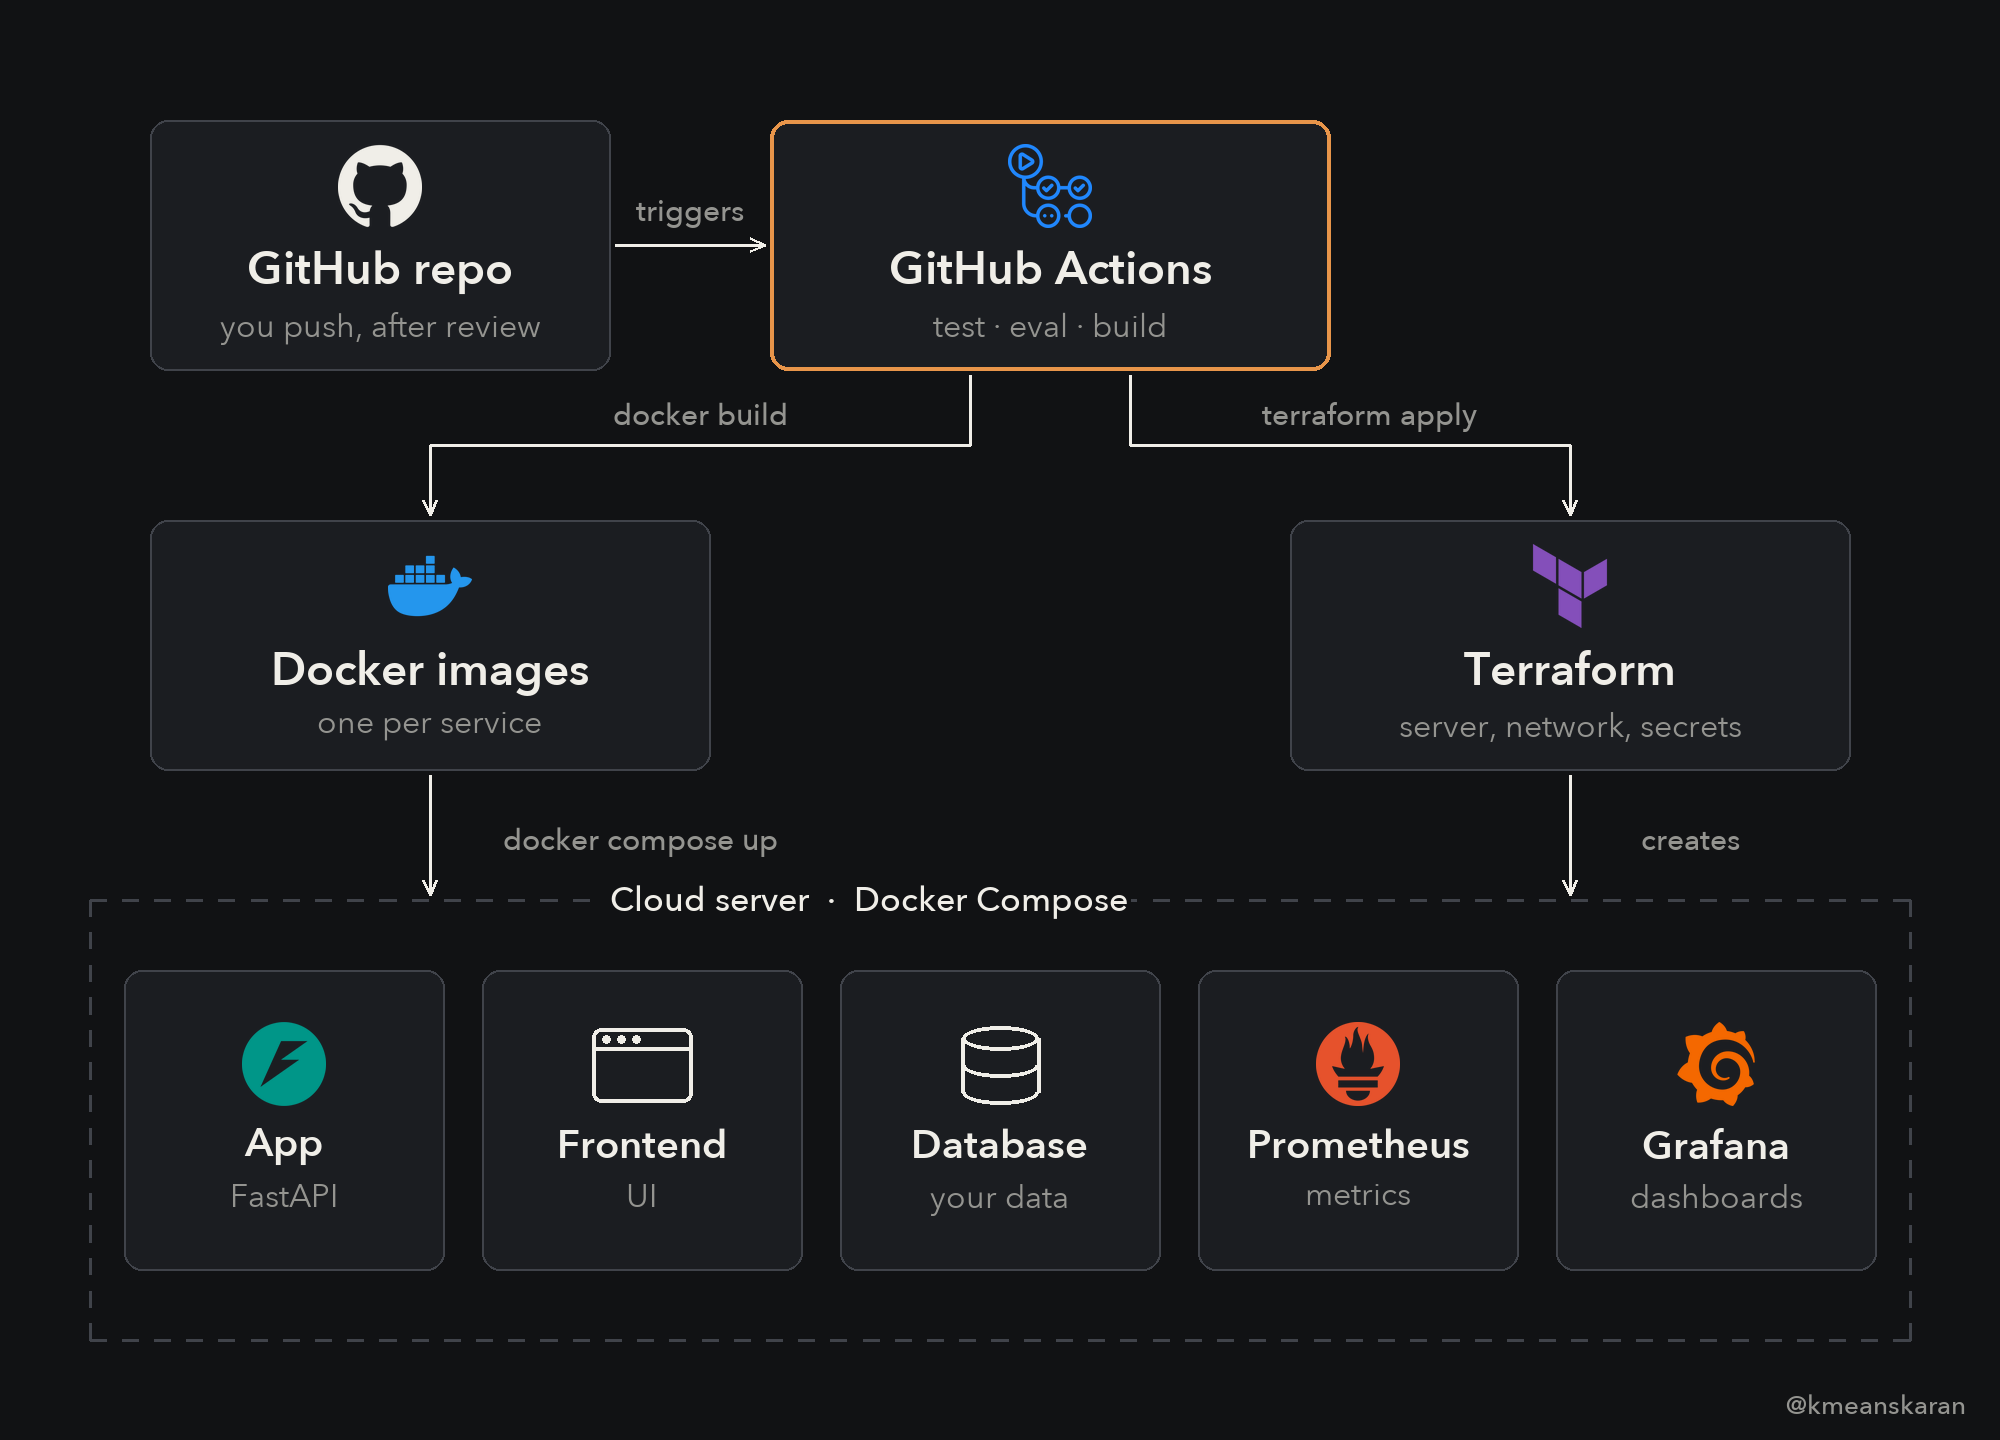
部署層面採用 Docker + Docker Compose + Terraform + GitHub Actions 標準組合,將應用、資料庫與觀測組件(Prometheus、Grafana)容器化。
架構權衡 (Trade-offs)
- 優勢 (Pros): 自動化評測腳本將耗時數小時的人工 UAT 壓縮至單次執行,提前攔截來源衝突與超時退化;
- 劣勢與成本 (Cons & Overheads): LLM-as-a-Judge 存在評判偏誤,維護 95+ 組黃金測試集需持續投入領域知識;
- 選型建議: 對回答準確性、來源可追溯性與延遲有嚴格 SLA 要求時,必須強制導入自動化 Eval 管線;
總結與結論
- 工程價值的 90/10 轉移:AI 已接管 90% 編碼工作,但決定專案生死的最後 10%——系統設計、異質資料清理、邊界條件處理、自動化評測框架與人工決策——是區分優秀架構師與平庸操作員的分水嶺。
- 從「寫程式」轉向「設計護欄與迴圈」:鎖定一致的專案目錄結構、利用開放格式
skills/固化業務與性能約束,並嚴守人工 Code Review 與 Git Commit 控制權,。 - 評測與極簡設計優先:在緊迫商業交期下,保持技術棧極簡以降低除錯複雜度,並將最大精力投入涵蓋「來源一致性」與「延遲邊界」的自動化評測——快速且來源正確的回答,永遠勝過超時失敗的完美答案。
Source URL: https://x.com/kmeanskaran/status/2117604283583713570